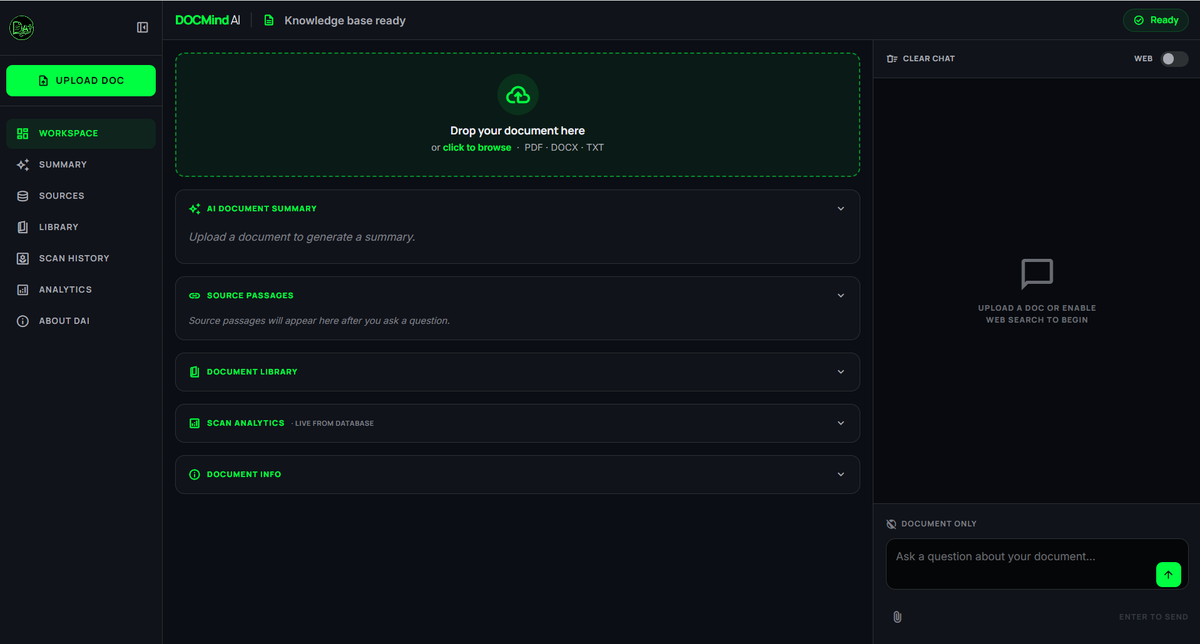
Why Hybrid Retrieval
Standard vector search frequently misses exact part numbers, model codes, and acronyms inside dense engineering manuals. DocMindAI fuses dense semantic vectors with sparse lexical keyword matching.
Hybrid Retrieval Architecture: FAISS + BM25 + RRF
- Dense Vector Search: On-disk FAISS index using
all-MiniLM-L6-v2(384-dimensional semantic embeddings). - Sparse Keyword Matching:
rank_bm25index to catch exact part numbers and serial codes. - Reciprocal Rank Fusion (RRF): Merges dense and sparse rankings with reciprocal rank math, so exact part numbers rank alongside semantic matches.
- Interactive CLI Demo: Includes
demo_hybrid_retrieval.pyfor side-by-side benchmarking of vector vs. keyword vs. hybrid fusion.
Capabilities
- Exact Document Scoping: Restricts query context to user-selected PDF manuals or whole libraries.
- SQL Analytics: Natural language questions translate into exact SQL analytics against metadata tables.
- Containerised: Dockerfile and
.dockerignorefor container deployment.
Tech Stack & Repositories
- Frameworks & Search: Python, Flask, LangChain, FAISS, rank_bm25.
- LLM Synthesis: Claude 3.5 Haiku API with strict citation grounding.
- DevOps: Docker, pytest (6/6 passing tests).
- GitHub Repository: docmindai-rag-chatbot